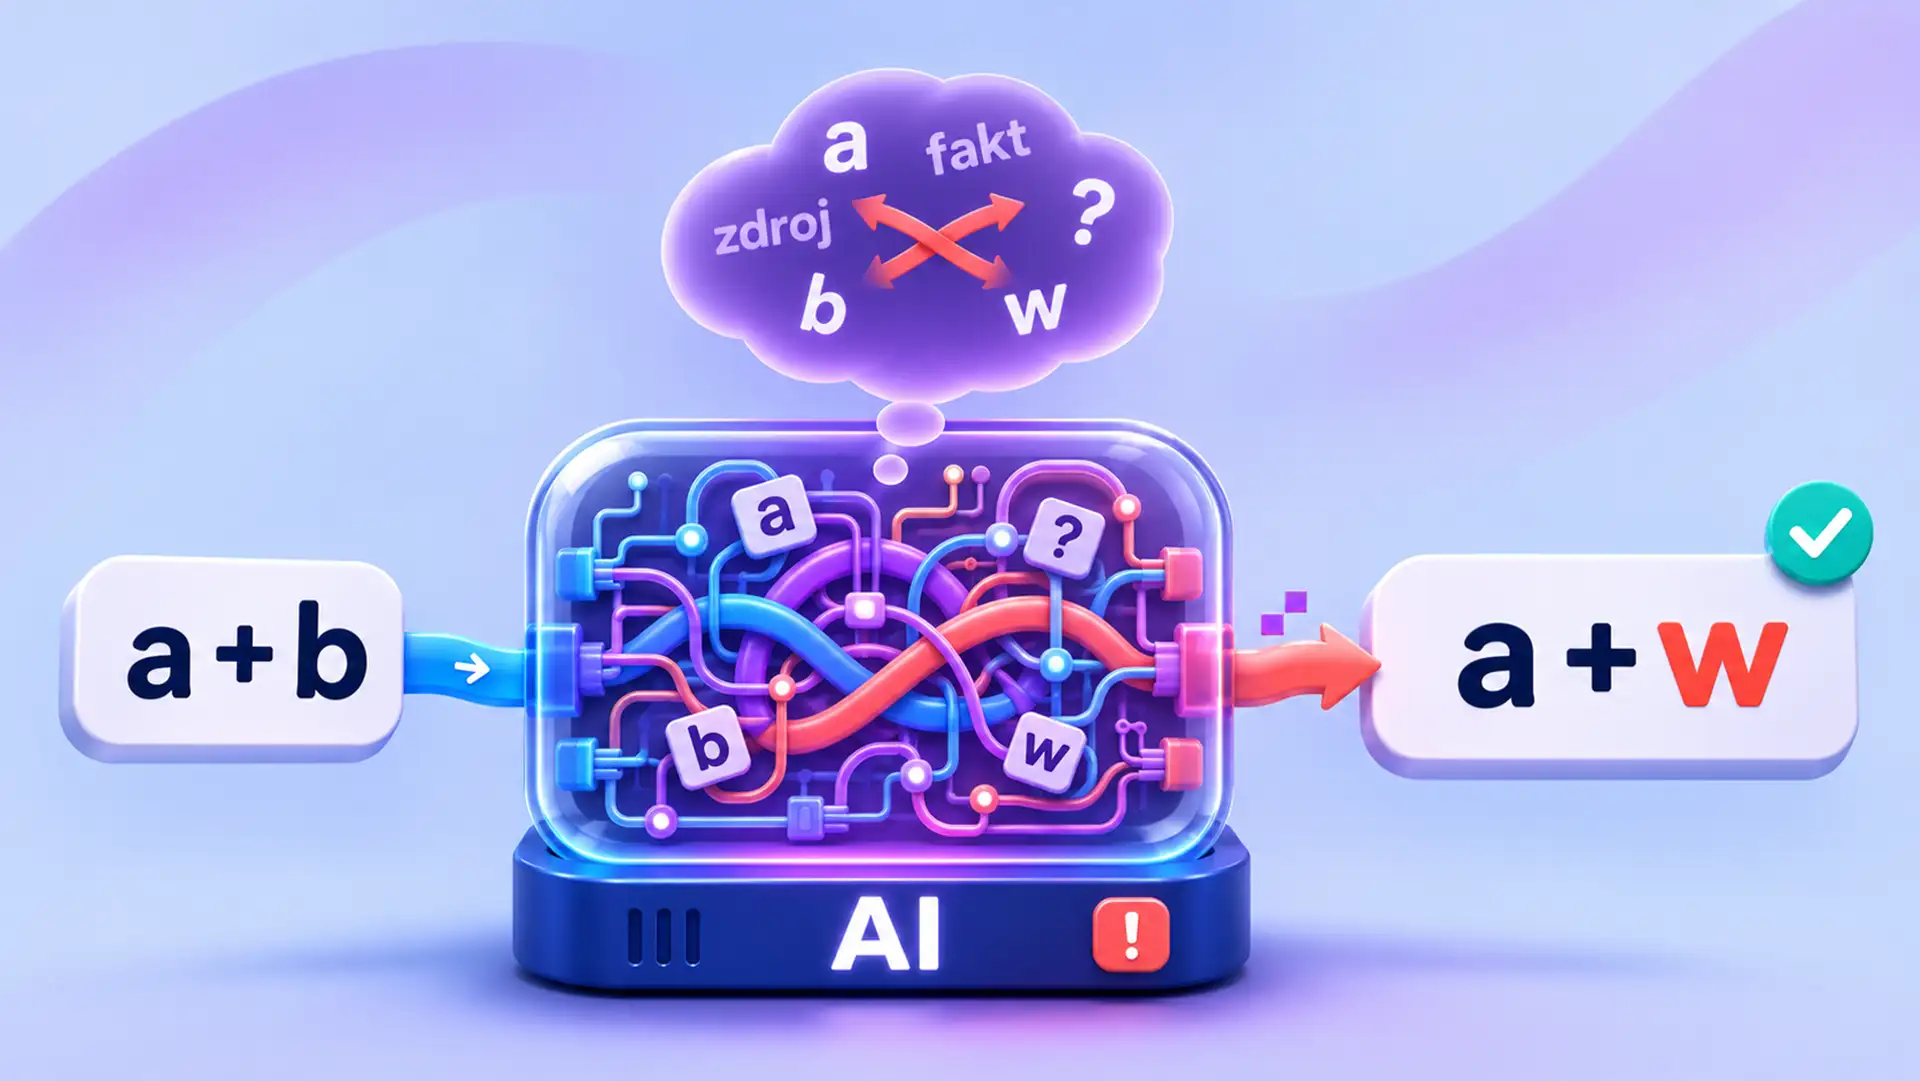
Halucinácia v AI je odpoveď jazykového modelu, ktorá znie sebaisto a správne, no obsahuje nepravdivé alebo vymyslené informácie, napríklad čísla, mená, citácie, súdne rozhodnutia či odkazy, ktoré neexistujú.
Model pritom nič nezamlčuje a nelže v ľudskom zmysle. Skladá najpravdepodobnejší text, a keď fakt nepozná, skladá ho aj tak. Preto sa halucinácia nedá poznať podľa tónu: vymyslený údaj znie rovnako istotne ako správny.
Článok vysvetľuje, čo halucinácia presne je, kde vzniká (v dátach, v tréningu, v hodnotení modelov alebo v zadaní) a či ide o chybu kódu, používateľa alebo promptu. Prináša čísla od tvorcov modelov a z nezávislých testov, porovnanie modelov a odpoveď, či sa to časom zlepšuje. Na príklade analýzy exportu z Google Search Console ukazuje, ako vyzerá slabé a ako komplexné zadanie. Čísla sú k 5. 11. 2026 a pri každom je uvedené, čo sa meralo.
- Čo to je: hodnoverne znejúce, ale nepravdivé tvrdenie jazykového modelu.
- Odkiaľ sa berie: nie z chyby v kóde. Vzniká z predpovedania slov, z medzier v dátach a z toho, že testy odmeňujú tipovanie viac než „neviem“.
- Ako často: záleží na úlohe. Pri sumarizácii textu jednotky až nízke desiatky percent, pri otázkach z pamäte a v odborných oblastiach desiatky percent.
- Zlepšuje sa to? Áno, ale žiadny model v teste FACTS od Google DeepMind nepresiahol 70 % a úplné odstránenie nesľubuje nikto.
- Čo pomáha: konkrétne zadanie, dodané zdroje, povolenie „neviem“, citácie a overenie výstupu.
Čo je halucinácia v AI?
Halucinácia je výstup jazykového modelu, ktorý je nepravdivý, no podaný ako pravdivý. OpenAI ju definuje ako hodnoverne znejúce, ale nepravdivé tvrdenia generované jazykovými modelmi (v origináli „plausible but false statements“, OpenAI). Formálna definícia z teoretickej práce Xu, Jain a Kankanhalli (2024) je širšia: halucinácia je každý prípad, keď sa výstup modelu líši od správneho výstupu pre daný vstup.
V praxi sa stretneme s tromi podobami, podľa toho, čo sa porovnáva so skutočnosťou. Každá má iný zdroj problému aj iný spôsob merania.
| Podoba | Čo sa stane | Príklad | Kto to meria |
|---|---|---|---|
| Vymyslený fakt | Model uvedie nepravdivý údaj zo svojej „pamäte“ | Zlý rok, meno, číslo alebo neexistujúca štúdia | SimpleQA (OpenAI), AA-Omniscience, FACTS Parametric |
| Nevernosť voči zdroju | Model dostane text a v zhrnutí pridá niečo, čo v ňom nie je | Zhrnutie článku obsahuje tvrdenie, ktoré v článku nie je | Vectara HHEM |
| Vymyslená opora | Model tvrdí, že zdroj niečo hovorí, hoci nehovorí | Citácia súdneho rozhodnutia, ktoré neexistuje | Stanford (Magesh a kol.) |
Čo halucinácia nie je?
Halucinácia nie je klamstvo, lebo model nemá úmysel ani vedomosť, že údaj je nepravdivý. Nie je to ani každá chyba. Zastaraný údaj z tréningu, chyba v zadaní alebo nesprávny výpočet sú príbuzné problémy, pri halucinácii však ide o vymyslený obsah podaný ako fakt.
Nie je to ani zriedkavý okrajový jav. Je to bežná vlastnosť všetkých veľkých jazykových modelov, ktorú tvorcovia otvorene priznávajú (viď kapitoly o číslach a o tom, či sa halucinácia dá odstrániť).
Prečo AI halucinuje a je to chyba kódu, používateľa, promptu alebo dát?
Halucinácia nie je chyba v programovom kóde. Vzniká štatisticky: z toho, ako sa modely učia a ako sa hodnotia. Podľa práce Kalai a kol. (OpenAI a Georgia Tech, 2025) ide o dve prepojené príčiny, štatistický princíp predtrénovania a spôsob, akým sa modely porovnávajú v testoch. Tabuľka ukazuje, ktoré príčiny majú oporu v použitých zdrojoch.
| Možná príčina | Je zdrojom halucinácie? | Čo o tom hovoria zdroje |
|---|---|---|
| Chyba v kóde (bug) | Nie | Mechanizmus je štatistický, nie programátorský |
| Predtrénovanie (predpovedanie ďalšieho slova) | Áno, hlavná príčina | Zriedkavé fakty sa zo vzorov odvodiť nedajú |
| Hodnotenie modelov (testy) | Áno, hlavný dôvod, prečo to pretrváva | Tipovanie dostane viac bodov než „neviem“ |
| Chyby a medzery v dátach | Áno, čiastočne | Chyby v tréningových dátach sa prenášajú do modelu |
| Slabá reprezentácia | Áno, čiastočne | Napríklad počítanie písmen kvôli tokenizácii |
| Prompt (zadanie) | Zosilňuje alebo znižuje | Vágne zadanie zvyšuje, konkrétne znižuje (viď kapitola o prompte) |
| Používateľ | Nepriamo | Neoverený výstup zmení chybu modelu na chybu v praxi |
Prečo model hádá, keď fakt nepozná?
Model sa učí predpovedať ďalšie slovo v obrovskom množstve textu, v ktorom nie je označené, čo je pravda. Pravidelné vzory, napríklad pravopis alebo zátvorky, sa s veľkosťou modelu učia čoraz lepšie. Ľubovoľné zriedkavé fakty, napríklad dátum narodenia konkrétnej osoby, sa z textových vzorov odvodiť nedajú, a tak model doplní hodnoverne znejúcu odpoveď.
Kalai a kol. z toho odvodzujú, že pri takýchto faktoch je miera halucinácie aspoň taká vysoká, ako je podiel faktov, ktoré sa v tréningových dátach objavili len raz. Ďalšie príčiny, ktoré uvádzajú, sú slabá reprezentácia v modeli, zadania mimo tréningových dát, výpočtovo neriešiteľné otázky a chyby, ktoré už boli v dátach.
Prečo modely radšej hádajú, než by povedali „neviem“?
Väčšina benchmarkov, teda testov, podľa ktorých sa modely porovnávajú, hodnotí odpoveď binárne: správne alebo nesprávne. „Neviem“ dostane nula bodov, tipovanie má aspoň šancu na bod. Kalai a kol. preskúmali desať populárnych testov a zistili, že väčšina používa binárne hodnotenie bez bodov za priznanú neistotu. Model, ktorý tipuje, tak v rebríčku vyzerá lepšie než opatrnejší model.
Názorne to ukazuje tabuľka z OpenAI (test SimpleQA zo systémovej karty GPT-5).
| Model | Odmietol odpovedať | Správne | Chybná odpoveď |
|---|---|---|---|
| gpt-5-thinking-mini | 52 % | 22 % | 26 % |
| OpenAI o4-mini | 1 % | 24 % | 75 % |
OpenAI navrhuje hodnotiť sebaisté chyby prísnejšie než priznanú neistotu a dávať čiastočné body za primerané vyjadrenie neistoty.
Ako často AI halucinuje? Štatistiky od tvorcov modelov a z nezávislých testov
Jedno všeobecné číslo neexistuje, lebo každý test meria niečo iné. Preto je pri každom údaji uvedené, čo sa meralo a kedy.
| Zdroj | Čo sa meralo | Výsledok |
|---|---|---|
| OpenAI, systémová karta GPT-5 (2025) | Faktické otázky z pamäte bez internetu (SimpleQA) | Chybovosť 26 % (gpt-5-thinking-mini) a 75 % (o4-mini) |
| Google DeepMind, FACTS (dec. 2025) | Faktickosť: pamäť, vyhľadávanie, obrázky, ukotvenie v texte | Najlepší model Gemini 3 Pro 68,8 %. Všetky hodnotené modely pod 70 % |
| Vectara, nový rebríček (nov. 2025) | Vernosť sumarizácie, viac než 7 700 článkov | Gemini-2.5-flash-lite 3,3 %, Gemini-3-pro 13,6 %. GPT-5, Claude Sonnet 4.5, Grok-4 a DeepSeek-R1 nad 10 % |
| Stanford, Magesh a kol. (2025), 202 dopytov | Právne nástroje s vyhľadávaním (RAG) | Lexis+ AI a Ask Practical Law AI okolo 17 %, Westlaw AI-Assisted Research okolo 33 % |
| Dahl a kol. (2024), podľa Stanfordu | Všeobecné chatboty na právne otázky | 58 až 82 % |
| Anthropic, systémová karta Claude Opus 4.5 (nov. 2025) | Faktické otázky (Simple-QA Verified, AA-Omniscience) | Zlepšenie o 11 percentuálnych bodov oproti predchádzajúcim Claude modelom. Bez externých nástrojov halucinácie nezmizli |
Prečo sa čísla o halucináciách tak líšia?
Rozdiely vznikajú z niekoľkých dôvodov. Pri sumarizácii textu, ktorý model dostal, sú chyby v jednotkách percent. Pri otázkach z pamäte sa rátajú v desiatkach percent.
- Má model zdroj? Text pred sebou znižuje riziko oproti odpovedi z pamäte.
- Oblasť. Právo a medicína obsahujú veľa zriedkavých presných faktov, napríklad čísla spisov a paragrafy.
- Metrika. Test môže počítať iba chyby, alebo aj odmietnuté odpovede. Model, ktorý odmieta, vyzerá lepšie, hoci je menej užitočný.
- Nástroje. Model s prístupom na web alebo do databázy chybuje menej než ten istý model bez nich, ale chyby nezmiznú.
Ktoré AI modely halucinujú viac a ktoré menej?
Poradie závisí od testu, preto jednoznačný „najlepší“ model neexistuje. Tu sú tri nezávislé pohľady. Prvý je aktuálny k 5. 11. 2026, ďalšie dva pochádzajú z roku 2025 a ukazujú rozptyl výsledkov, nie dnešné poradie.
Ktorý model má podľa AA-Omniscience najnižšiu mieru halucinácie?
AA-Omniscience je test faktických znalostí, ktorý odmeňuje správnu odpoveď a trestá nesprávnu. Odmietnutie odpovede nemá trest. Miera halucinácie je podiel nepravdivých odpovedí zo všetkých nesprávnych pokusov, teda nie zo všetkých otázok. Aktuálna verzia 1.1 má 3 000 otázok v šiestich oblastiach a vyšla v októbri 2026.
| Kategória | Model | Hodnota |
|---|---|---|
| Najnižšia miera halucinácie | Google Gemini 4 Argon (High) | 4 % |
| 2. najnižšia miera halucinácie | Google Gemini 4 Carbon (High) | 11 % |
| 3. najnižšia miera halucinácie | Command A+ | 14 % |
| Najvyšší Omniscience Index | Google Gemini 4 Carbon (High) | 54 |
| 2. najvyšší Omniscience Index | Anthropic Claude Opus 5.5 (Max) | 48 |
| 3. najvyšší Omniscience Index | Anthropic Claude Fable 5.1 (Max) | 46 |
| Najvyššia presnosť | Anthropic Claude Fable 5.1 (Max) | 68 % |
| 2. najvyššia presnosť | Anthropic Claude Fable 5.1 (Xhigh) | 67 % |
| 3. najvyššia presnosť | Anthropic Claude Opus 5.5 (Xhigh) | 66 % |
Najpresnejší model nie je ten s najnižšou mierou halucinácie. Presnosť hovorí, koľko otázok model zodpovedal správne. Miera halucinácie hovorí, ako často sa pomýli, keď odpovie. Model, ktorý častejšie odmietne, môže mať nižšiu halucináciu pri nižšej presnosti. Pri modeloch Claude stránka mieru halucinácie nezobrazuje, preto ju nemožno porovnať.
Pre prvú verziu testu (november 2025, 6 000 otázok) sa uvádzalo napríklad pre Gemini 3 Pro presnosť 53 % a mieru halucinácie 88 %, pre GPT-5.1 (high) 39 % a 81 % a pre Grok 4 39 % a 64 % (The Decoder). Čísla verzie 1 a 1.1 nie sú priamo porovnateľné.
Čo ukazuje Vectara rebríček halucinácií pri sumarizácii?
Vectara meria, či zhrnutie verne zodpovedá článku. Zhrnutie sa považuje za halucináciu, ak ho detektor HHEM ohodnotí pod 0,5. Pôvodný rebríček mal 955 článkov, nový z novembra 2025 viac než 7 700 a texty až do 32 tisíc tokenov. Vectara uvádza, že pôvodná sada už modely nerozlišovala, lebo sa zhlukovali, a že nový test dáva všeobecne vyššie čísla.
Druhý pohľad prináša odborná práca o rebríčku (Vectara, 2025) s metódou FaithJudge. Ide o priemer cez sumarizáciu, odpovede na otázky a generovanie textu z dát. Je to výber z roku 2025, takže slúži ako ukážka rozptylu a nie ako aktuálne poradie.
| Model | Tvorca | Miera halucinácie |
|---|---|---|
| gemini-2.5-pro | 6,65 % | |
| gpt-4.5-preview | OpenAI | 11,94 % |
| gpt-4o | OpenAI | 15,85 % |
| claude-3.7-sonnet | Anthropic | 16,05 % |
| llama-3.3-70b | Meta | 16,44 % |
| llama-4-maverick | Meta | 20,55 % |
| llama-3.1-8b | Meta | 28,38 % |
Halucinujú viac reasoning modely, teda modely s „premýšľaním“?
Nie jednoznačne. V teste PersonQA, ktorý sa pýta na údaje o osobách, halucinoval podľa systémovej karty OpenAI model o3 v 33 % a o4-mini v 48 % prípadov, oproti 16 % pri o1 (systémová karta). OpenAI uviedla, že príčina nie je známa. Podľa karty o3 tvrdí celkovo viac vecí, takže vzniká viac správnych aj viac nesprávnych tvrdení. Premýšľanie teda halucinácie nezaručene zníži, výsledok závisí od modelu a úlohy.
Znižuje sa miera halucinácií v AI časom, alebo tu bude vždy?
Obe tvrdenia platia súčasne: čísla sa zlepšujú, no nulu nikto nesľubuje.
Zlepšenie je viditeľné pri novších modeloch. Claude Opus 4.5 sa v teste Simple-QA Verified zlepšil o 11 percentuálnych bodov oproti predchádzajúcim modelom Claude (systémová karta). V AA-Omniscience mal v novembri 2025 Gemini 3 Pro mieru halucinácie 88 % (verzia 1), dnes je najnižšia hodnota 4 % (Gemini 4 Argon, verzia 1.1). Verzie testu sa líšia počtom otázok aj obsahom, takže ide o smer a nie o presné porovnanie.
- Novšie modely majú lepšie výsledky vo faktických testoch (Claude Opus 4.5 o 11 percentuálnych bodov v Simple-QA Verified, Gemini 4 v AA-Omniscience).
- Niektoré modely odmietajú, keď si nie sú istí (gpt-5-thinking-mini odmietol v SimpleQA 52 % otázok), a test AA-Omniscience odmietnutie netrestá.
- Modely o3 a o4-mini halucinovali na PersonQA viac než o1.
- Žiadny model nepresiahol v teste FACTS 70 % (dec. 2025). V novom Vectara teste boli viaceré známe modely nad 10 %.
Dá sa halucinácia v AI úplne odstrániť?
Podľa dostupných zdrojov nie. OpenAI uvádza, že presnosť nikdy nedosiahne 100 %, lebo niektoré otázky sú zo svojej podstaty nezodpovedateľné. Halucinácie podľa nej nie sú nevyhnutné v tom zmysle, že model môže odmietnuť odpovedať, keď si nie je istý (OpenAI).
Anthropic píše, že jej techniky halucinácie výrazne znižujú, no úplne ich neodstránia, a odporúča overovať kritické informácie (dokumentácia). Teoretická práca Xu a kol. dokazuje, že pri modeloch používaných ako všeobecný riešič úloh sa halucinácia úplne odstrániť nedá, nech je architektúra, tréning či prompt akýkoľvek. Ide o teoretický výsledok, nie o meranie.
Praktický záver: počítajme s tým, že sa halucinácia vyskytne, a postavme na tom proces so zdrojmi, overením a kontrolou.
Aké sú reálne príklady halucinácie AI a aké škody spôsobila?
Čo sa stalo v prípade Mata v. Avianca s vymyslenými citáciami z ChatGPT?
V spore pred federálnym súdom v New Yorku (2023) použil právnik žalobcu ChatGPT na právny výskum a podanie odkazovalo na neexistujúce súdne rozhodnutia s vymyslenými citátmi. Pri overovaní sa opýtal samotného ChatGPT, ktoré tvrdilo, že rozhodnutia sú pravé. Sudca P. Kevin Castel konštatoval zlú vieru oboch právnikov a uložil im spolu s ich kanceláriou pokutu 5 000 USD (rozhodnutie súdu).
Čo sa stalo s analýzou Deloitte pre austrálsku vládu?
Deloitte pripravil pre austrálske ministerstvo zamestnanosti a pracovných vzťahov nezávislú analýzu systému sankcií za nesplnené povinnosti poberateľov dávok v hodnote 440 000 AUD. Obsahovala viac než desať vymyslených odkazov a poznámok pod čiarou, vymyslený úryvok súdneho rozsudku a vymyslený citát pripisovaný sudcovi. Deloitte priznal použitie generatívnej AI (Azure OpenAI GPT-4o) a vrátil poslednú splátku zmluvy. Chybu odhalil akademik z univerzity v Sydney a prípad sa objavil v októbri 2025 (The Register). Ministerstvo následne zverejnilo opravenú správu z 26. 9. 2025, ktorá nahradila pôvodnú zo 4. 7. 2025 a opravila citácie a zoznam literatúry (správa ministerstva).
Oba prípady majú rovnaký vzorec: vymyslená opora, teda citácia alebo rozsudok, a neoverenie ľudskou kontrolou.
Ako ovplyvňuje prompt mieru halucinácie?
Zadanie nemení, čo model vie, ale mení, koľko priestoru dostane na domýšľanie. Výskum to potvrdzuje, no s výhradami.
V štúdii Frontiers in Artificial Intelligence (Anh-Hoang a kol., 2025) porovnali päť typov promptov na piatich open-source modeloch a štyroch datasetoch.
| Typ promptu | Podiel halucinácií |
|---|---|
| Vágny alebo zavádzajúci | 38,3 % |
| Zero-shot (bez príkladov) | 34,5 % |
| Few-shot (s príkladmi) | 27,2 % |
| Inštrukcia | 24,6 % |
| Chain-of-Thought (postupné uvažovanie) | 18,1 % |
Autori uvádzajú, že halucinácie majú prompt-závislú aj modelovú zložku, že Chain-of-Thought nefunguje všeobecne a pri modeli bez potrebných vedomostí môže urobiť nesprávnu odpoveď len podrobnejšou. Štúdia má aj vnútorné nezrovnalosti: tvrdí, že testovala len open-source modely, no uvádza aj výsledky GPT-4. Preto ju berieme ako orientačnú. Niektoré blogy pripisujú hodnotu 18,1 % „štruktúrovanému promptu“, v štúdii však patrí Chain-of-Thought.
Rawte a kol. (2023) testovali 15 modelov od GPT-2 po GPT-4 a zistili, že formálnejšie a konkrétnejšie prompty vedú k menej halucináciám, najmä pri číslach, skratkách, osobách a miestach. Pri čitateľnosti bol obraz zmiešaný. Presné hodnoty sú v štúdii len v grafoch.
Ako vyzerá slabý a ako komplexný prompt? Príklad analýzy exportu zo Search Console
Príklad je ilustračný a nejde o meranie. Zodpovedá úlohe, ktorú pri vývoji vlastných nástrojov na analýzu webov a textov riešime opakovane: dať AI export dopytov z Google Search Console a získať z neho závery. Zistili sme, že samotné zlepšenie zadania nestačí, preto pri analýzach, ako je porovnanie obsahu konkurencie, aj výstup kontrolujeme kódom, napríklad či kľúčové slová, ktoré AI vrátila, sa naozaj nachádzajú v texte stránky.
Prečo je vágne zadanie na analýzu exportu rizikové?
Tu je export kľúčových slov zo Search Console. Analyzuj ho a napíš, ktoré kľúčové slová sú pre web najdôležitejšie a čo by sme mali vylepšiť. (+ vložených 5 000 riadkov)
Takéto zadanie necháva modelu takmer všetko na domýšľanie. Výsledkom je plynulý text, v ktorom sa čísla a odporúčania nedajú skontrolovať.
- Kritérium. „Najdôležitejšie“ a „vylepšiť“ nič nemerajú, model si ich vyloží po svojom.
- Štruktúra. Päťtisíc riadkov bez pokynu, ktoré stĺpce sú dôležité.
- Pravidlo pre chýbajúce dáta. Model radšej vymyslí, než by povedal „neviem“.
- Obmedzenie zdroja. Nič nezakazuje použiť vedomosti mimo tabuľky.
- Slovenčina. Slová majú veľa tvarov (topánky, topánok, topánkam) a model ich môže zlúčiť alebo „opraviť“.
- Merateľné kritérium. Pozícia 8 až 20 a aspoň 100 zobrazení.
- Obmedzený vstup. Len priložená tabuľka a výslovný zákaz iných informácií.
- Únikové pravidlo. Povolené „chýba v dátach“.
- Pevný výstup. JSON, ktorý sa dá strojovo skontrolovať.
- Pravidlá pre slovenčinu. Slová nechať v pôvodnom tvare.
Ako vyzerá komplexný prompt na analýzu exportu zo Search Console?
Z priloženej tabuľky vyber najviac 10 kľúčových slov s najväčším potenciálom rastu.
Kľúčové slovo má pozíciu 8 až 20 a aspoň 100 zobrazení. Zoraď ich zostupne podľa zobrazení.
Len tabuľka nižšie (stĺpce: dopyt, kliky, zobrazenia, pozícia). Nepoužívaj žiadne iné informácie.
- Kľúčové slová prepíš presne v pôvodnom tvare, nič neskloňuj ani neopravuj.
- Čísla preber z tabuľky, žiadne neprepočítavaj ani neodhaduj.
- Ak kritérium splní menej ako 10 slov, vráť len tie, ktoré ho splnili.
- Ak niečo v dátach chýba, napíš „chýba v dátach“.
JSON v tvare:[{"dopyt": "...", "zobrazenia": 0, "pozicia": 0}]
Model tu už nič neinterpretuje, len filtruje podľa pravidla. Rozdiel je v tom, že každé tvrdenie vo výstupe sa dá porovnať s tabuľkou.
Prečo ani dobrý prompt nedá nulovú chybu?
Aj pri dobrom zadaní môže model niečo pokaziť, napríklad vynechať riadok alebo prepísať číslo. Preto má zmysel výstup overovať kódom: či každé kľúčové slovo naozaj existuje v pôvodnej tabuľke a či sa čísla zhodujú. Dobrý prompt znižuje riziko halucinácie, overenie výstupu ju zachytí. Veľké dáta tiež radšej rozdeľujeme na menšie časti a výsledky spájame, namiesto vloženia všetkých riadkov naraz. Toto je naša prax, nie výsledok merania.
Prečo musí mať AI povolené odpovedať „neviem“ a ako to zadať?
Jedna z najúčinnejších ochrán proti halucinácii je výslovne povedať modelu, že smie priznať, že odpoveď nepozná. Bez takého pokynu sa model správa tak, ako ho vedie tréning a hodnotenie: odpoveď dostane viac bodov než „neviem“, a tak radšej odpovie, aj keď potrebnú informáciu nemá.
Anthropic uvádza povolenie „neviem“ ako prvú zo siedmich techník a píše, že výslovné dovolenie priznať neistotu môže výrazne znížiť množstvo nepravdivých informácií (dokumentácia). OpenAI zároveň uvádza, že halucinácie nie sú nevyhnutné, lebo model môže odmietnuť odpovedať, keď si nie je istý (OpenAI).
Ako vyzerá pravidlo „neviem“ v prompte?
Pravidlo má tri časti: kedy platí, čo má model napísať namiesto odpovede a čo nesmie urobiť. Ukážka je ilustračná.
Ak v dodaných údajoch nie je dosť informácií na správnu odpoveď, odpovedz presne: „Neviem. V dodaných údajoch na to chýbajú informácie.“
Nedopĺňaj odpoveď z vlastných vedomostí a žiadne údaje, čísla ani zdroje nedomýšľaj.
Ak vieš odpovedať len na časť otázky, odpovedz na ňu a pri zvyšku napíš, čo presne chýba.
Čo sa stane, keď model smie odpovedať „neviem“?
Najnázornejšie to ukazuje test SimpleQA zo systémovej karty GPT-5. Model gpt-5-thinking-mini odmietol odpovedať v 52 % prípadov a mal chybovosť 26 %, kým o4-mini odmietol len v 1 % prípadov a mal chybovosť 75 %. Presnosť pritom bola takmer rovnaká, 22 % a 24 % (OpenAI).
Model, ktorý častejšie priznal neistotu, mal teda výrazne menej nesprávnych odpovedí pri presnosti nižšej len o dva body. Ide však o porovnanie dvoch rôznych modelov, nie o ten istý model s pravidlom a bez neho. Odpoveď „neviem“ nie je zlyhanie. Je to správny výsledok, keď dáta na odpoveď nestačia.
Čo si pri pravidle „neviem“ strážiť?
Model môže začať odmietať aj to, čo by vedel, ak je pravidlo napísané príliš všeobecne. Preto ho podľa našej praxe píšeme konkrétne, teda aj s tým, z čoho má model čerpať a čo presne má napísať. Výsledok overujeme na vzorke, či model neodmieta zbytočne.
Odpoveď „neviem“ treba pripraviť aj na strane spracovania. Ak výstup číta kód, musí byť „neviem“ alebo „chýba v dátach“ povolená hodnota, aby sa nepovažovala za chybu. Toto je naša prax, nie výsledok merania.
Prečo AI pri dlhej práci zabúda zadanie a zdroje a ako tomu predísť?
Pri dlhej analýze, v projekte alebo v Claude Code sa stáva, že model po čase prestane dodržiavať pravidlá zo začiatku alebo pracuje bez dokumentu, ktorý dostal na úvod. Zabúdanie nie je to isté ako halucinácia. Súvisí s ňou tak, že ak podklad alebo pokyn vypadne z dosahu modelu, nemá sa o čo oprieť. Toto prepojenie je náš záver, zdroje nižšie opisujú zabúdanie a pokles presnosti.
Čo model „vidí“ a čo si pamätá?
Model nemá trvalú pamäť. Pri každej odpovedi pracuje len s kontextovým oknom, teda s textom, ktorý dostane na vstup: pokyny, konverzácia, nahrané súbory, výstupy nástrojov aj jeho vlastné predchádzajúce odpovede. Dokumentácia Anthropic ho prirovnáva k pracovnej pamäti (dokumentácia). Nový chat alebo nová relácia v Claude Code začína s prázdnym oknom a nesie len to, čo sa doň načíta zo súborov (Claude Code).
Prečo kvalita klesá, aj keď sa všetko ešte zmestí do okna?
Väčšie okno neznamená, že model využije všetko rovnako dobre. Anthropic píše, že s rastúcim počtom tokenov klesá presnosť aj schopnosť informáciu vybaviť, a nazýva to context rot. Preto záleží nielen na tom, koľko miesta v okne zostáva, ale aj na tom, čo v ňom je (dokumentácia). Novšie modely Claude majú okno až 1 milión tokenov, no väčšie okno samo osebe kvalitu nezaručuje.
| Zdroj | Čo zistili |
|---|---|
| Liu a kol. (2023) | Modely fungujú najlepšie, keď je dôležitá informácia na začiatku alebo na konci vstupu. V strede dlhého vstupu výkon výrazne klesá, aj u modelov určených na dlhý kontext. |
| Chroma, Context Rot (14. 7. 2025) | Test 18 modelov od Anthropic, OpenAI, Google a Alibaba. Spoľahlivosť klesá s dĺžkou vstupu aj pri jednoduchých úlohách. Už jeden tematicky blízky rušivý text znížil presnosť a štyri ju znížili ešte viac. |
| Chroma, test LongMemEval | Pri 306 otázkach mali modely výrazne lepšie výsledky so zameraným vstupom okolo 300 tokenov než s celou históriou, ktorá mala v priemere okolo 113 000 tokenov. |
Čo sa stane, keď sa okno naplní?
Nástroje preto staršiu časť konverzácie skracujú alebo zhrňujú. Claude Code pri blížiacom sa limite najprv maže staršie výstupy nástrojov a potom konverzáciu zhrnie. Požiadavky a dôležité úryvky kódu zostanú, no podrobné pokyny zo začiatku konverzácie sa môžu stratiť (Claude Code). V claude.ai Claude pri zapnutom spúšťaní kódu zhrnie staršie správy, keď sa chat blíži k limitu. Celá história ostáva uložená (Claude Help Center).
Do zhrnutia sa nemusí dostať práve to, na čom nám záleží: zoznam povolených zdrojov, pravidlo „neviem“ alebo formát výstupu. Je to náš príklad, dokumentácia hovorí všeobecne o podrobných pokynoch.
Ako zabrániť zabúdaniu pri dlhých analýzach, projektoch a v Claude Code?
- Trvalé pravidlá ulož do súboru, nie do konverzácie. V Claude Code sa súbor CLAUDE.md po kompaktovaní znova načíta z disku, kým pokyn zadaný len v konverzácii môže zmiznúť (Claude Code).
- Pred dlhou úlohou kompaktuj s fokusom. Príkaz /compact s pokynom, čo zachovať, alebo sekcia „Compact Instructions“ v CLAUDE.md (Claude Code).
- Medzi nesúvisiacimi úlohami začni odznova. Príkaz /clear zahodí starú konverzáciu, ktorá inak vytláča súbory potrebné pre ďalšiu úlohu a stojí tokeny pri každej správe (Claude Code).
- Veľké čítania nechaj subagentovi. Pracuje vo vlastnom okne a vráti len zhrnutie (Claude Code).
- Priebežné výsledky zapisuj do súboru. Anthropic opisuje poznámky uložené mimo okna, napríklad v súbore NOTES.md, ktoré agent neskôr načíta späť (Anthropic).
- V projektoch v claude.ai pomenuj dokumenty výstižne. Keď znalosti v projekte blížia limitu, Claude ich nenačíta všetky, ale vyhľadáva v nich relevantné časti a odpovedá z nájdených úryvkov (Claude Help Center).
Súbor CLAUDE.md je len kontext, nie vynútené pravidlo. Podľa dokumentácie platí, že čím konkrétnejšie a stručnejšie pokyny sú, tým dôslednejšie ich Claude dodržiava. Čo sa musí dodržať vždy, treba vynútiť technicky, pomocou hooku (Claude Code).
Ako znížiť halucinácie AI a čo skutočne pomáha?
Žiadna technika halucináciu neodstráni, no viaceré ju výrazne znižujú. Dokumentácia Anthropic uvádza sedem techník a výslovne píše, že halucinácie výrazne znižujú, no úplne ich neodstránia (Anthropic).
| # | Technika | Čo robí |
|---|---|---|
| 1 | Povoliť „neviem“ | Model smie priznať neistotu |
| 2 | Priame citáty | Pri dlhých dokumentoch najprv doslovné úryvky, potom úloha |
| 3 | Overenie citáciami | Ku každému tvrdeniu citát. Ak ho model nenájde, tvrdenie stiahne |
| 4 | Kontrola uvažovania | Pri podozrivej odpovedi prejsť zhrnutie uvažovania a nájsť chybný predpoklad |
| 5 | Best-of-N | Spustiť rovnaký prompt viackrát a porovnať. Rozdiely signalizujú halucináciu |
| 6 | Iteratívne spresnenie | Výstup vrátiť modelu a požiadať o overenie |
| 7 | Obmedzenie na dané zdroje | Zakázať všeobecné vedomosti |
Pomáha vyhľadávanie na webe a RAG?
Pomáha, ale problém nerieši úplne. Pri RAG model pred odpoveďou vyhľadá zdroje a z nich vytvorí odpoveď. Stanford zistil, že právne nástroje s takým vyhľadávaním halucinujú menej než GPT-4, no stále v 17 až 33 % prípadov, hoci poskytovatelia sľubovali odstránenie halucinácií (Magesh a kol.). Odpoveď s odkazmi preto neznamená odpoveď bez chýb. Treba skontrolovať, či zdroj naozaj hovorí to, čo model tvrdí.
Čo je Chain-of-Verification?
Je to metóda od Meta (Dhuliawala a kol., 2023). Model napíše návrh odpovede, naplánuje overovacie otázky, zodpovie ich nezávisle od návrhu a vytvorí opravenú odpoveď. Autori uvádzajú zníženie halucinácií naprieč úlohami, konkrétne pri zoznamoch z Wikidata, uzavretých otázkach MultiSpanQA a dlhých textoch. Halucinácie nevylučuje.
Čo kontrolovať ako prvé, keď nemáme čas overiť všetko?
Presné údaje sú najčastejším miestom vymysleného obsahu.
Otvoriť zdroj a pozrieť, či hovorí to, čo model tvrdí.
Tu je cena chyby najvyššia.
Ak niečo znie presne a nemá zdroj, overme to ako prvé.
Dá sa halucináciám úplne vyhnúť?
Nie. Žiadna jednotlivá technika halucináciu nevylúči a podľa OpenAI, Anthropic aj teoretickej práce Xu a kol. sa nulová miera nedá zaručiť. Preto sa ochrany vrstvia, aby chybu zachytila aspoň jedna z nich.
Konkrétna úloha, merateľné kritérium, obmedzený vstup a povolené „neviem“.
Dodané dokumenty alebo vyhľadávanie a citácia ku každému tvrdeniu.
Kód overí, či údaje existujú v zdroji, či sedia čísla a formát.
Kontrola kritických tvrdení: čísla, citácie, právne, zdravotné a finančné údaje.
Čo je na záver dôležité vedieť o halucináciách AI?
Halucinácia je vlastnosť jazykových modelov, nie chyba programu. Vzniká z toho, že model predpovedá pravdepodobný text, a z toho, že testy odmeňujú tipovanie viac než priznané „neviem“. Miera sa líši podľa úlohy od jednotiek percent pri sumarizácii po desiatky percent pri otázkach z pamäte a v odborných oblastiach. Novšie modely sú lepšie, no žiaden hodnotený model nepresiahol v teste FACTS 70 %.
Zadanie halucináciu zvyšuje alebo znižuje. Prompt s merateľným kritériom, obmedzeným vstupom, povolením „neviem“ a pevným formátom výstupu dáva modelu menej priestoru na domýšľanie, a overenie výstupu kódom alebo človekom zachytí zvyšok. Pri dlhých úlohách treba pravidlá a zdroje uložiť do súboru alebo projektu, lebo staršia časť konverzácie sa pri zaplnení okna skracuje.
Rovnaký princíp platí aj pre web. Podľa nášho výkladu dávajú jasné a overiteľné informácie na stránke AI menej priestoru domýšľať si o firme. O tom, ako sa web dostane do AI odpovedí, píšeme v článkoch GEO: ako byť citovaný v AI odpovediach a AEO: ako písať text, aby ho AI vybralo do odpovede. V rámci SEO a AI SEO na mieru preto pripravujeme obsah tak, aby bol faktický, overiteľný a zrozumiteľný aj pre AI.
Často kladené otázky o halucináciách v AI
Je halucinácia to isté ako klamstvo?
Halucinuje aj ChatGPT, Claude a Gemini?
Pomáha, keď AI pripojíme na internet?
Dá sa halucinácia úplne odstrániť?
Prečo má AI odpovedať „neviem“ namiesto domýšľania?
Prečo AI pri dlhej práci zabúda pokyny a podklady?
Pomôže do promptu napísať „nehalucinuj“?
Ako spoznáme, že AI halucinuje?
Oplatí sa používať AI na odborný obsah?
Zdroje
- OpenAI: Why language models hallucinateDefinícia halucinácie, príčiny (predtrénovanie, hodnotenie), tabuľka SimpleQA a návrh zmeny hodnotenia.
- Kalai, Nachum, Vempala, Zhang: Why Language Models Hallucinate (arXiv:2509.04664)Štatistický pôvod halucinácií a rozbor desiatich testov s binárnym hodnotením.
- Xu, Jain, Kankanhalli: Hallucination is Inevitable (arXiv:2401.11817)Formálna definícia a dôkaz, že halucináciu nemožno úplne odstrániť.
- Anthropic: Reduce hallucinationsSedem techník na zníženie halucinácií a vyhlásenie, že ich úplne neodstránia.
- Anthropic: Claude Opus 4.5 System Card (november 2025)Kapitola o faktických otázkach: Simple-QA Verified a AA-Omniscience.
- Google DeepMind: FACTS Benchmark Suite (9. 12. 2025)Štyri testy faktickosti, Gemini 3 Pro 68,8 % a vyhlásenie, že všetky modely sú pod 70 %.
- Vectara: Introducing the next generation of Vectara’s Hallucination Leaderboard (19. 11. 2025)Nový rebríčok vernosti sumarizácie, viac než 7 700 článkov, metóda HHEM.
- Benchmarking LLM Faithfulness in RAG with Evolving Leaderboards (arXiv:2505.04847)Odborná práca o Vectara rebríčku a výsledky FaithJudge (tabuľka 7).
- Artificial Analysis: AA-OmniscienceAktuálny stav verzie 1.1: miera halucinácie, presnosť a Omniscience Index.
- The Decoder: Gemini 3 Pro tops new AI reliability benchmarkČísla prvej verzie AA-Omniscience z novembra 2025.
- Magesh a kol.: Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools (arXiv:2405.20362)Preregistrované porovnanie právnych nástrojov s vyhľadávaním, 202 dopytov.
- Anh-Hoang a kol.: Survey and analysis of hallucinations in LLMs, Frontiers in AI (2025)Porovnanie piatich typov promptov a úvaha o príčinách v prompte a v modeli.
- Rawte a kol.: Exploring the Relationship between LLM Hallucinations and Prompt Linguistic Nuances (arXiv:2309.11064)Vplyv čitateľnosti, formálnosti a konkrétnosti promptu na halucinácie u 15 modelov.
- Dhuliawala a kol. (Meta): Chain-of-Verification Reduces Hallucination in LLMs (arXiv:2309.11495)Metóda overovacích otázok na zníženie halucinácií.
- Anthropic: Context windows (dokumentácia)Kontextové okno ako pracovná pamäť, context rot, veľkosti okien modelov Claude.
- Anthropic: Effective context engineering for AI agents (29. 9. 2025)Obmedzený rozpočet pozornosti, kompaktovanie, poznámky mimo okna a subagenty pri dlhých úlohách.
- Liu a kol.: Lost in the Middle: How Language Models Use Long Contexts (arXiv:2307.03172)Výkon modelov je najlepší na začiatku a na konci vstupu a klesá v strede.
- Chroma: Context Rot: How Increasing Input Tokens Impacts LLM Performance (14. 7. 2025)Test 18 modelov, pokles spoľahlivosti s dĺžkou vstupu, vplyv rušivých textov, LongMemEval.
- Claude Code Docs: How Claude Code worksČo sa stane, keď sa kontext naplní, kompaktovanie, subagenty a príkaz /compact.
- Claude Code Docs: Explore the context windowČo prežije kompaktovanie, príkazy /compact a /clear, delegovanie čítania subagentom.
- Claude Code Docs: How Claude remembers your projectCLAUDE.md a automatická pamäť, pokyny zadané len v konverzácii po kompaktovaní.
- Claude Help Center: How do usage and length limits work?Limit dĺžky chatu a zhrnutie starších správ pri zapnutom spúšťaní kódu.
- Claude Help Center: Retrieval augmented generation (RAG) for projectsPrepnutie projektu na vyhľadávanie, keď znalosti blížia limitu kontextu.
- OpenAI: o3 and o4-mini System CardVýsledky testu PersonQA pre o1, o3 a o4-mini (tabuľka 4).
- Mata v. Avianca, Inc., 22-cv-1461 (S.D.N.Y.): Opinion and Order on Sanctions (22. 6. 2023)Súdne rozhodnutie o vymyslených citáciách z ChatGPT a pokute 5 000 USD.
- Ministerstvo zamestnanosti a pracovných vzťahov (DEWR): Targeted Compliance Framework Assurance Review – Final ReportOpravená verzia správy z 26. 9. 2025, ktorá nahradila verziu zo 4. 7. 2025.
- The Register: Deloitte refunds Aussie gov after AI fabrications slip into $440K welfare report (6. 10. 2025)Vymyslené odkazy a citát v správe pre austrálsku vládu a vrátená splátka.